
2026 年にオンラインの匿名性を守る方法: 完全ガイド
真のオンライン・プライバシーは偶然に得られるものではありません。堅牢なデータ保護は、常に適切なツール、不正防止アルゴリズムへの深い理解、そして定期的なセキュリティ監査に支えられています。プロフェッショナル向けの匿名化ツールを使えば、数分であなたのデジタル・フットプリントを完全に覆い隠すことができます。
ここでは、オンラインのデータ保護がどのように機能するのか、標準的な手法がなぜ通用しなくなっているのか、そして高度に安全なテックスタックをどのように構築するのかを分解して解説します。
デジタル・フットプリントとは? 不正防止システムはそれをどう分析するのか
「デジタル・フットプリント」とは、あなたが広告プラットフォーム、セキュリティシステム、ウェブサイトを訪れるたびに収集される膨大なデータの痕跡のことです。現在、Google、Meta、主要ECプラットフォームが用いるニューラルネットワーク型の不正防止システムは、単なるIPアドレス以上の情報を追跡します。オペレーティングシステムのパラメーター、ブラウザーのバージョン、言語、画面解像度、そしてCanvas、Client Hints、WebGLといった隠れたハードウェア指標から、固有の「Device Fingerprint(デバイス・フィンガープリント)」を構築します。
さらに高度な不正防止アルゴリズムは、接続のネットワーク層も分析します。ここは偽装行為が露見しやすい層でもあります。セキュリティシステムが特に注目するのは以下の点です。
- 受動的OSフィンガープリンティング(TCP/IP): アンチディテクトブラウザーのプロファイルがWindowsを模倣していても、ネットワークパケット層(TTLやWindow Sizeのパラメーター)にLinuxサーバー特有の特徴が現れていれば、セッションは即座にフラグされます。
- レイテンシの不一致(Ping vs. Geo): プロキシがニューヨークにあると主張しているのに、実際のプロバイダーの物理サーバーがヨーロッパにある場合、不自然に高いPingがプロキシ経路を即座に露呈させます。
- MTU(Maximum Transmission Unit)の異常: 標準的なネットワークパケットサイズを変更すること(例:1500バイトから1400)へ低下)は、トラフィックがトンネルやVPNを経由していることを示します。
専門的なセットアップなしでは、オンラインでのあらゆる行動は丸見えです。データの主導権を取り戻すには、アンチディテクトブラウザーと高い信頼度のプロキシを組み合わせたプロフェッショナルなスタックを導入する必要があります。
ネットワークの匿名性が重要な理由
オンラインのワークフローを管理する際、プロフェッショナルはたいてい次の2つの危険な極端に直面します。
- 基本的なブラウザー設定や標準のシークレット(Incognito)モードに頼ること。これはISPや対象ウェブサーバーからトラフィックを隠すことができません。
- 無作為な無料ツールを使うこと。これは、データ漏洩や認証情報の窃取、低品質トラフィックによる分析の歪みといった重大なリスクを招きます。
バランスが取れた専門的アプローチは、信頼できる中庸を提供します。
- 実際の位置情報とネットワークインフラのパラメーターを完全にマスクします。
- 金融取引、認証情報、機微なビジネス通信を傍受から保護します。
- 対象サイトから、通常の自然なユーザーとして認識されるようにします。これにより、恒常的なブロック、認証の壁、CAPTCHAが取り除かれ、最終的に自動化の効率が最大化されます。
タスク別に最適なツールを選ぶには
保護の中核原則は同じでも、タスクによって必要なインフラ構成はまったく異なります。プロキシはアプリケーション、スクリプト、またはブラウザープロファイルのレベルで正確に動作するため、この防御の背骨です。ブラインドテストで予算を燃やさないためには、プロキシの種類をユースケースに正しくマッピングすることが重要です。
1. マルチアカウント運用と登録(Google、ソーシャルメディア)
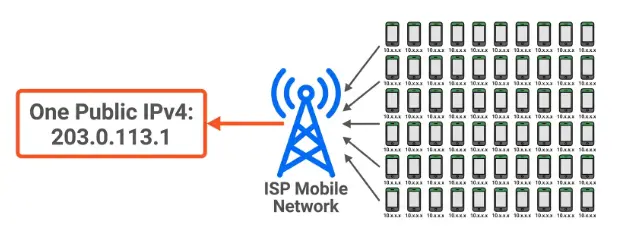
大量のアカウント作成には、モバイルプロキシが不可欠です。これらのIPアドレスは、実在のセルラーネットワーク利用者数千人によって同時に共有されています。不正防止システムは、無関係な消費者数千人を巻き込まずにモバイルIPを容易にブロックすることができません。この高いトラストスコアによって、サインアップ時に遭遇する厳格な電話番号認証のトリガーを大幅に減らせます。
2. プロファイル管理とアカウントのウォーミング
多数のプロファイルを常時モバイル回線で維持するのは費用効率がよくありません。長期運用には、スティッキーなレジデンシャルプロキシ(固定セッション)に切り替えましょう。これは一般的な家庭用Wi‑Fi接続を模倣します。ここでの目標は、実在のコンシューマー向けISPに属するクリーンなASN(Autonomous System Numbers)を持ち、高いレピュテーションスコアを提供するレジデンシャルIPプロバイダーを選ぶことです。AWSやDigitalOceanのようなクラウドデータセンター所属のASNは避けてください。
3. Webスクレイピングとデータ抽出
大規模なデータセットの抽出には、自動的なIPローテーションが必要です。こうした自動化スクレイピングのワークフローには、高速でFraud-Scoresが低く、継続的なデータ収集が可能でCAPTCHAに継続的に阻まれないような巨大IPプールを探してください。
いずれのサービスを購入する前にも、速度、稼働率(アップタイム)、プールの純度、ネットワークの一貫性といった技術指標を必ず分析しましょう。過密な市場を見通し、人気プロバイダーの独立したパフォーマンステスト、速度上限、匿名性評価を確認するには、ToProxyLabのような特化型アグリゲーターを活用できます。
盤石の匿名化ワークフローを構築する
段階的なプライバシー設定は、次の論理に従います。
- 目的を定義する: 基本的なウェブ閲覧には簡易な暗号化で十分です。複雑なタスク(複数プロファイルの管理、マーケティング自動化、データスクレイピング)には、アンチディテクトブラウザーとプロキシを緊密に統合したセットアップが必要です。
- システムパラメーターを同期する: ブラウザープロファイルの言語、タイムゾーン、位置情報が、プロキシサーバーの正確なGEOと一致していることを常に確認してください。突発的な地理的ジャンプ(Geo-Hops)は避けましょう。
- 実際のプール性能を分析する: トップティアのプロバイダー間で、IPの純度、接続の安定性、価格を比較します。評判を維持するためにプールの健全性を最優先する確立されたブランドに注力しましょう。
- ターゲティングを精緻化する: 必要な国、地域、都市、あるいはモバイルキャリアのレベルまで精密にカバーできるプロバイダーを選びます。
結論
データ保護の要諦は、体系的に取り組み、自分のオペレーションに合わせて技術を最適化することです。ネットワークフィルターや隠れた不正防止トリガーの仕組みを理解すれば、高いアカウント審査通過率、滑らかな自動化、そして2026\における妥協のないプライバシーを保証するインフラ構成を実現できます。