
Cách bảo vệ danh tính ẩn danh trực tuyến của bạn vào năm 2026: Hướng dẫn đầy đủ
Quyền riêng tư trực tuyến thực sự không tự nhiên mà có. Bảo vệ dữ liệu vững chắc luôn dựa vào đúng công cụ, hiểu sâu về các thuật toán chống gian lận và kiểm toán bảo mật định kỳ. Các công cụ ẩn danh chuyên nghiệp có thể che mờ hoàn toàn dấu vết số của bạn chỉ trong vài phút.
Hãy cùng phân tích cách thức bảo vệ dữ liệu trực tuyến hoạt động, vì sao các phương pháp tiêu chuẩn không còn đủ, và cách xây dựng một bộ công cụ công nghệ có độ an toàn cao.
Dấu vết số (Digital Footprint) là gì và các hệ thống chống gian lận phân tích nó như thế nào?
Một dấu vết số là chuỗi dữ liệu khổng lồ được các nền tảng quảng cáo, hệ thống bảo mật và website thu thập mỗi lần bạn truy cập. Ngày nay, các hệ thống chống gian lận dựa trên mạng nơ-ron (được Google, Meta và các nền tảng thương mại điện tử lớn sử dụng) theo dõi nhiều hơn rất nhiều so với chỉ địa chỉ IP của bạn. Chúng xây dựng một Dấu vân thiết bị (Device Fingerprint) độc nhất gồm các tham số hệ điều hành, phiên bản trình duyệt, ngôn ngữ, độ phân giải màn hình và các chỉ dấu phần cứng ẩn (như Canvas, Client Hints và WebGL).
Hơn nữa, các thuật toán chống gian lận tiên tiến phân tích tầng mạng của kết nối, nơi các nỗ lực giả mạo thường bị lộ. Các hệ thống bảo mật đặc biệt tìm kiếm:
- Passive OS Fingerprinting (TCP/IP): Nếu hồ sơ trình duyệt anti-detect bắt chước Windows, nhưng ở cấp gói mạng (qua tham số TTL và Window Size) lại để lộ đặc trưng máy chủ Linux, phiên của bạn sẽ bị gắn cờ ngay lập tức.
- Sai lệch độ trễ (Ping so với vị trí địa lý): Nếu proxy tuyên bố ở New York, nhưng máy chủ vật lý của nhà cung cấp đặt tại châu Âu, độ trễ ping cao bất thường sẽ ngay lập tức phơi bày tuyến proxy.
- Bất thường MTU (Maximum Transmission Unit): Việc thay đổi kích thước gói mạng chuẩn (ví dụ, giảm từ 1500 bytes xuống 1400) cho thấy lưu lượng đang được định tuyến qua đường hầm hoặc VPN.
Nếu không có cấu hình chuyên dụng, mọi hành động trực tuyến đều minh bạch. Để giành lại quyền kiểm soát dữ liệu, bạn phải triển khai một bộ công cụ chuyên nghiệp kết hợp trình duyệt anti-detect với proxy có độ tin cậy cao.
Tại sao ẩn danh mạng lại quan trọng
Khi quản lý quy trình làm việc trực tuyến, các chuyên gia thường đối mặt với hai thái cực nguy hiểm:
- Dựa vào cài đặt trình duyệt cơ bản hoặc chế độ Ẩn danh tiêu chuẩn, vốn không che giấu được lưu lượng của bạn khỏi ISP hay máy chủ web đích.
- Sử dụng các công cụ miễn phí ngẫu nhiên, làm gia tăng rủi ro rò rỉ dữ liệu, đánh cắp thông tin đăng nhập và sai lệch phân tích do chất lượng lưu lượng kém.
Một cách tiếp cận cân bằng, chuyên nghiệp mang lại giải pháp đáng tin cậy ở giữa:
- Bạn che giấu hoàn toàn vị trí thực và các tham số hạ tầng mạng.
- Bạn bảo vệ giao dịch tài chính, thông tin đăng nhập và liên lạc kinh doanh nhạy cảm khỏi bị đánh chặn.
- Bạn bảo đảm các website mục tiêu nhìn nhận bạn như người dùng hữu cơ thông thường. Điều này loại bỏ tình trạng chặn liên tục, tường xác minh và CAPTCHA, cuối cùng tối đa hóa hiệu quả tự động hóa.
Cách chọn công cụ phù hợp cho từng tác vụ cụ thể
Dù nguyên tắc cốt lõi của bảo vệ vẫn giống nhau, từng tác vụ lại đòi hỏi cấu hình hạ tầng hoàn toàn khác. Proxy là xương sống của lớp phòng thủ này vì chúng hoạt động chính xác ở tầng ứng dụng, script hoặc hồ sơ trình duyệt. Để tránh đốt ngân sách cho các thử nghiệm mò mẫm, điều tối quan trọng là ánh xạ các loại proxy với trường hợp sử dụng cụ thể:
1. Đa tài khoản và đăng ký (Google, mạng xã hội)
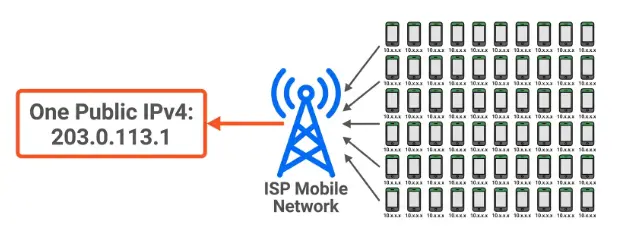
Với việc tạo hàng loạt tài khoản, proxy di động (Mobile Proxies) là điều thiết yếu. IP của chúng được hàng nghìn người dùng mạng di động thực sử dụng đồng thời. Các hệ thống chống gian lận không thể dễ dàng chặn một IP di động mà không làm gián đoạn hàng nghìn người dùng vô tội. Nhờ điểm tin cậy cao này, IP di động giảm đáng kể các kích hoạt xác minh số điện thoại gắt gao trong quá trình đăng ký.
2. Quản lý hồ sơ và nuôi (hâm nóng) tài khoản
Duy trì một mạng lưới lớn hồ sơ luôn chạy trên dữ liệu di động là không hiệu quả về chi phí. Cho quản lý dài hạn, hãy chuyển sang proxy dân cư sticky. Chúng mô phỏng kết nối Wi‑Fi gia đình thông thường. Mục tiêu ở đây là chọn nhà cung cấp IP dân cư có điểm danh tiếng cao và các ASN sạch thuộc về các ISP tiêu dùng thực, thay vì trung tâm dữ liệu đám mây (như AWS hoặc DigitalOcean).
3. Web scraping và trích xuất dữ liệu
Trích xuất các bộ dữ liệu lớn đòi hỏi xoay IP tự động. Với các quy trình scraping tự động này, hãy tìm các pool IP khổng lồ có tốc độ cao và Fraud-Score thấp để bảo đảm thu thập dữ liệu liên tục mà không đụng phải CAPTCHA dai dẳng.
Trước khi mua bất kỳ dịch vụ nào, luôn phân tích các chỉ số kỹ thuật như tốc độ, thời gian hoạt động, độ sạch của pool và tính nhất quán mạng. Để định hướng trong thị trường dày đặc này và xem các bài kiểm thử hiệu năng độc lập, giới hạn tốc độ, cùng xếp hạng ẩn danh của các nhà cung cấp phổ biến, bạn có thể dùng các nền tảng tổng hợp chuyên dụng như ToProxyLab.
Xây dựng quy trình ẩn danh vững chắc
Thiết lập quyền riêng tư theo từng bước sẽ đi theo logic sau:
- Xác định mục tiêu: Với lướt web cơ bản, mã hóa đơn giản là đủ. Với các tác vụ phức tạp (quản lý nhiều hồ sơ, tự động hóa marketing, scraping dữ liệu), bạn cần thiết lập tích hợp chặt chẽ giữa trình duyệt anti-detect và proxy.
- Đồng bộ tham số hệ thống: Luôn bảo đảm ngôn ngữ, múi giờ và vị trí địa lý của hồ sơ trình duyệt khớp chính xác GEO của máy chủ proxy. Tránh các cú nhảy địa lý đột ngột (Geo-Hops).
- Phân tích hiệu năng thực của pool: So sánh độ sạch IP, độ ổn định kết nối và mức giá giữa các nhà cung cấp top-tier. Tập trung vào các thương hiệu đã được khẳng định, ưu tiên sức khỏe pool để duy trì danh tiếng.
- Tinh chỉnh nhắm mục tiêu: Chọn nhà cung cấp có độ phủ chính xác tới quốc gia, vùng, thành phố, hoặc nhà mạng di động cụ thể bạn cần.
Kết luận
Mấu chốt của bảo vệ dữ liệu là tiếp cận một cách có phương pháp và điều chỉnh công nghệ theo đúng hoạt động cụ thể của bạn. Hiểu cách các bộ lọc mạng và các kích hoạt chống gian lận ẩn vận hành cho phép bạn xây dựng cấu hình hạ tầng bảo đảm tỷ lệ đậu kiểm duyệt tài khoản cao, tự động hóa trơn tru và quyền riêng tư không thỏa hiệp vào năm 2026.