
Come proteggere il tuo anonimato online nel 2026: la guida completa
La vera privacy online non accade per caso. Una protezione dei dati solida si basa sempre sugli strumenti giusti, su una profonda comprensione degli algoritmi antifrode e su audit di sicurezza periodici. Strumenti professionali di anonimato possono oscurare completamente la tua impronta digitale in pochi minuti.
Analizziamo come funziona la protezione dei dati online, perché i metodi standard non sono più sufficienti e come costruire uno stack tecnologico altamente sicuro.
Cos’è un’impronta digitale e come la analizzano i sistemi antifrode?
Un’impronta digitale è l’enorme scia di dati raccolti da piattaforme pubblicitarie, sistemi di sicurezza e siti web ogni volta che li visiti. Oggi, i sistemi antifrode basati su reti neurali (utilizzati da Google, Meta e dalle principali piattaforme e-commerce) tracciano molto più del semplice indirizzo IP. Creano una Device Fingerprint unica composta dai parametri del sistema operativo, versione del browser, lingua, risoluzione dello schermo e marcatori hardware nascosti (come Canvas, Client Hints e WebGL).
Inoltre, gli algoritmi antifrode avanzati analizzano il livello di rete della tua connessione, che è spesso il punto in cui vengono smascherati i tentativi di spoofing. I sistemi di sicurezza cercano in particolare:
- Fingerprinting passivo del SO (TCP/IP): se il profilo del tuo browser anti-detect imita Windows, ma a livello di pacchetto di rete (tramite i parametri TTL e Window Size) emergono caratteristiche tipiche di un server Linux, la tua sessione viene immediatamente segnalata.
- Incongruenze di latenza (Ping vs. Geo): se il tuo proxy dichiara di trovarsi a New York, ma il server fisico del provider è in Europa, l’elevato ping innaturale rende immediatamente evidente l’instradamento via proxy.
- Anomalie dell’MTU (Maximum Transmission Unit): modificare la dimensione standard dei pacchetti di rete (ad es. passando da 1500 byte a 1400) indica che il traffico viene instradato attraverso un tunnel o una VPN.
Senza una configurazione specializzata, ogni azione online è trasparente. Per riprendere il controllo dei tuoi dati, devi adottare uno stack professionale che combini browser anti-detect con proxy ad alta reputazione.
Perché l’anonimato di rete è importante
Gestendo flussi di lavoro online, i professionisti si trovano di solito tra due estremi pericolosi:
- Affidarsi alle impostazioni di base del browser o alla modalità in incognito standard, che non nasconde il traffico agli ISP o ai server web di destinazione.
- Usare strumenti gratuiti casuali, che introducono elevati rischi di fuoriuscite di dati, furto di credenziali e analisi distorte a causa della scarsa qualità del traffico.
Un approccio equilibrato e professionale offre una via di mezzo affidabile:
- Mascheri completamente la tua posizione reale e i parametri della tua infrastruttura di rete.
- Proteggi transazioni finanziarie, credenziali e comunicazioni aziendali sensibili da intercettazioni.
- Garantisci che i siti di destinazione ti vedano come un utente normale e organico. Questo elimina blocchi continui, muri di verifica e CAPTCHA, massimizzando in definitiva l’efficienza dell’automazione.
Come scegliere gli strumenti giusti per attività specifiche
Sebbene i principi di base della protezione restino gli stessi, attività diverse richiedono configurazioni infrastrutturali completamente differenti. I proxy sono la spina dorsale di questa difesa perché operano esattamente a livello di applicazione, script o profilo del browser. Per evitare di bruciare budget in test alla cieca, è fondamentale mappare i tipi di proxy sui casi d’uso specifici:
1. Multi-accounting e registrazioni (Google, social media)
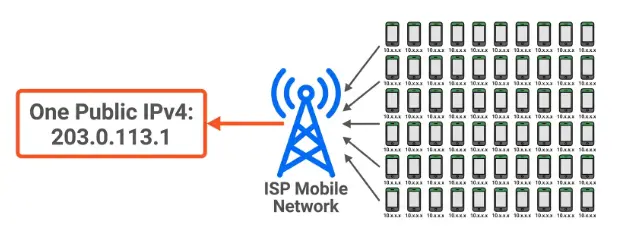
Per la creazione massiva di account, i proxy mobili sono essenziali. I loro indirizzi IP sono condivisi simultaneamente da migliaia di utenti reali di reti cellulari. I sistemi antifrode non possono bloccare facilmente un IP mobile senza tagliare fuori migliaia di consumatori innocenti. Grazie a questo alto livello di fiducia, gli IP mobili riducono in modo significativo gli stringenti trigger di verifica telefonica durante la registrazione.
2. Gestione dei profili e warm-up degli account
Mantenere una grande rete di profili permanentemente su dati mobili non è conveniente. Per la gestione a lungo termine, passa a proxy residenziali sticky. Imitano una normale connessione Wi‑Fi domestica. L’obiettivo qui è selezionare provider di IP residenziali che offrano alti punteggi di reputazione e ASN puliti appartenenti a veri ISP consumer, e non a data center cloud (come AWS o DigitalOcean).
3. Web scraping ed estrazione dati
L’estrazione di grandi dataset richiede una rotazione IP automatizzata. Per questi flussi di lavoro di scraping automatizzato, cerca pool IP massivi che offrano alte velocità e Fraud‑Score bassi, così da garantire una raccolta dati continua senza incappare in muri di CAPTCHA persistenti.
Prima di acquistare qualsiasi servizio, analizza sempre metriche tecniche come velocità, uptime, purezza del pool e coerenza della rete. Per orientarti in questo mercato saturo e consultare test prestazionali indipendenti, limiti di velocità e valutazioni di anonimato dei provider più popolari, puoi usare piattaforme aggregatrici specializzate come ToProxyLab.
Costruire un flusso di lavoro di anonimato a prova di bomba
Una configurazione della privacy passo‑passo segue questo percorso logico:
- Definisci il tuo obiettivo: per la semplice navigazione web basta una cifratura di base. Per attività complesse (gestione di più profili, automazione marketing, data scraping), ti serve un setup strettamente integrato di un browser anti-detect e proxy.
- Sincronizza i parametri di sistema: assicurati sempre che lingua, fuso orario e geolocalizzazione del profilo del browser coincidano con la GEO esatta del tuo server proxy. Evita salti geografici improvvisi (Geo‑Hops).
- Analizza le prestazioni reali del pool: confronta purezza degli IP, stabilità della connessione e prezzi tra i provider di fascia alta. Concentrati su marchi affermati che danno priorità alla salute del pool per mantenere la loro reputazione.
- Affina il targeting: scegli un provider con copertura precisa fino a paese, regione, città o operatore mobile specifici di cui hai bisogno.
Conclusione
La chiave della protezione dei dati è un approccio metodico e l’adattamento delle tecnologie alle tue operazioni specifiche. Capire come funzionano i filtri di rete e i trigger antifrode nascosti ti permette di mettere in sicurezza configurazioni infrastrutturali che garantiscono alti tassi di approvazione degli account, automazione fluida e una privacy senza compromessi nel 2026.