
Como proteger seu anonimato online em 2026: o guia completo
A verdadeira privacidade online não acontece por acaso. A proteção robusta de dados sempre depende das ferramentas certas, de uma compreensão profunda dos algoritmos antifraude e de auditorias de segurança regulares. Ferramentas profissionais de anonimato podem ocultar completamente sua pegada digital em questão de minutos.
Vamos explicar como funciona a proteção de dados online, por que os métodos padrão já não bastam e como montar um stack tecnológico altamente seguro.
O que é uma Pegada Digital e Como os Sistemas Antifraude a Analisam?
Uma pegada digital é o enorme rastro de dados coletado por plataformas de publicidade, sistemas de segurança e sites toda vez que você os visita. Hoje, sistemas antifraude baseados em redes neurais (usados pelo Google, Meta e grandes plataformas de e-commerce) acompanham muito mais do que apenas seu endereço IP. Eles constroem uma Device Fingerprint única, composta por parâmetros do seu sistema operacional, versão do navegador, idioma, resolução de tela e marcadores de hardware ocultos (como Canvas, Client Hints e WebGL).
Além disso, algoritmos antifraude avançados analisam a camada de rede da sua conexão, que é frequentemente onde tentativas de falsificação são expostas. Os sistemas de segurança procuram especificamente por:
- Passive OS Fingerprinting (TCP/IP): Se o seu perfil de navegador anti-detecção imita o Windows, mas o nível de pacotes de rede (via parâmetros TTL e Window Size) revela características de servidor Linux, sua sessão é sinalizada instantaneamente.
- Incompatibilidades de Latência (Ping vs. Geo): Se o seu proxy afirma estar em Nova York, mas o servidor físico do provedor fica na Europa, o ping anormalmente alto expõe instantaneamente o roteamento do proxy.
- Anomalias de MTU (Maximum Transmission Unit): Alterar o tamanho padrão do pacote de rede (por exemplo, reduzir de 1500 bytes para 1400) indica que o tráfego está sendo redirecionado por um túnel ou VPN.
Sem uma configuração especializada, toda ação online é transparente. Para retomar o controle sobre seus dados, você deve implementar um stack profissional que combine navegadores anti-detecção com proxies de alta confiança.
Por que o Anonimato de Rede é Importante
Ao gerenciar fluxos de trabalho online, os profissionais geralmente enfrentam dois extremos perigosos:
- Confiar em configurações básicas do navegador ou no modo anônimo padrão, que não consegue ocultar seu tráfego de ISPs ou dos servidores-alvo.
- Usar ferramentas gratuitas aleatórias, o que introduz altos riscos de vazamento de dados, roubo de credenciais e análises distorcidas devido à baixa qualidade do tráfego.
Uma abordagem equilibrada e especializada oferece um meio-termo confiável:
- Você mascara completamente sua localização real e os parâmetros de infraestrutura de rede.
- Você protege transações financeiras, credenciais e comunicações empresariais sensíveis contra interceptação.
- Você garante que os sites-alvo o vejam como um usuário comum e orgânico. Isso elimina bloqueios constantes, paredes de verificação e CAPTCHAs, maximizando sua eficiência de automação.
Como Escolher as Ferramentas Certas para Tarefas Específicas
Embora os princípios centrais de proteção permaneçam os mesmos, tarefas diferentes exigem configurações de infraestrutura completamente distintas. Proxies são a espinha dorsal dessa defesa porque operam precisamente no nível da aplicação, script ou perfil do navegador. Para evitar queimar orçamento com testes às cegas, é crucial mapear os tipos de proxy para casos de uso específicos:
1. Múltiplas Contas e Registros (Google, redes sociais)
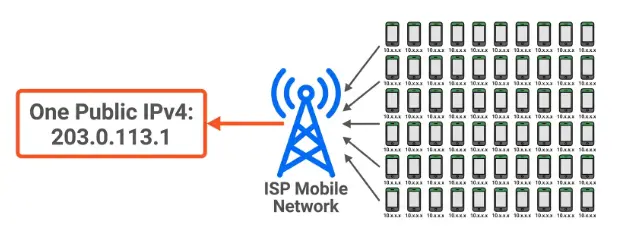
Para criação em massa de contas, proxies móveis são essenciais. Seus endereços IP são compartilhados simultaneamente por milhares de usuários reais de redes celulares. Os sistemas antifraude não conseguem bloquear facilmente um IP móvel sem cortar milhares de consumidores inocentes. Por causa desse alto nível de confiança, IPs móveis reduzem significativamente os gatilhos rigorosos de verificação telefônica encontrados durante o cadastro.
2. Gerenciamento de Perfis e Aquecimento de Contas
Manter uma grande rede de perfis permanentemente em dados móveis não é econômico. Para gerenciamento de longo prazo, migre para proxies residenciais sticky. Eles imitam uma conexão comum de Wi‑Fi doméstico. O objetivo aqui é selecionar provedores de IP residencial que ofereçam altos índices de reputação e ASNs (Autonomous System Numbers) limpos pertencentes a provedores de Internet (ISPs) de consumidores reais, e não a data centers de nuvem (como AWS ou DigitalOcean).
3. Web Scraping e Extração de Dados
Extrair grandes conjuntos de dados requer rotação automatizada de IPs. Para esses fluxos de scraping automatizados, procure por pools massivos de IP que ofereçam altas velocidades e baixos Fraud-Scores para garantir coleta contínua de dados sem enfrentar CAPTCHAs persistentes.
Antes de adquirir qualquer serviço, sempre analise métricas técnicas como velocidade, uptime, pureza do pool e consistência de rede. Para navegar por esse mercado superlotado e revisar testes independentes de desempenho, limites de velocidade e classificações de anonimato de provedores populares, você pode usar agregadores especializados como o ToProxyLab.
Construindo um Fluxo de Trabalho de Anonimato à Prova de Bala
Uma configuração de privacidade passo a passo segue este caminho lógico:
- Defina seu objetivo: Para navegação básica, criptografia simples é suficiente. Para tarefas complexas (gerenciamento de múltiplos perfis, automação de marketing, scraping de dados), você precisa de uma integração ajustada entre um navegador anti-detecção e proxies.
- Sincronize os parâmetros do sistema: Garanta sempre que o idioma, o fuso horário e a geolocalização do perfil do navegador correspondam exatamente ao GEO do seu servidor proxy. Evite saltos geográficos súbitos (Geo-Hops).
- Analise o desempenho real do pool: Compare pureza de IP, estabilidade de conexão e preços entre provedores de topo. Foque em marcas estabelecidas que priorizam a saúde do pool para manter a reputação.
- Refine sua segmentação: Escolha um provedor com cobertura precisa até o país, região, cidade ou operadora móvel específica de que você precisa.
Conclusão
A chave para a proteção de dados é abordá-la de forma metódica e adaptar as tecnologias às suas operações específicas. Entender como funcionam os filtros de rede e os gatilhos antifraude ocultos permite assegurar configurações de infraestrutura que garantem altas taxas de aprovação de contas, automação fluida e privacidade sem concessões em 2026.